GPT-6 Astra var den enda modellen som genomförde ett verkligt parkeringstest. Den körde 152 meter på fem minuter, i cirka 1,5 km/h, och förbrukade samtidigt 6,6 miljoner tokens till en kostnad av 7,74 dollar. Forskarteamet uppskattade att det motsvarar ungefär 500 gånger bränslekostnaden för samma sträcka.
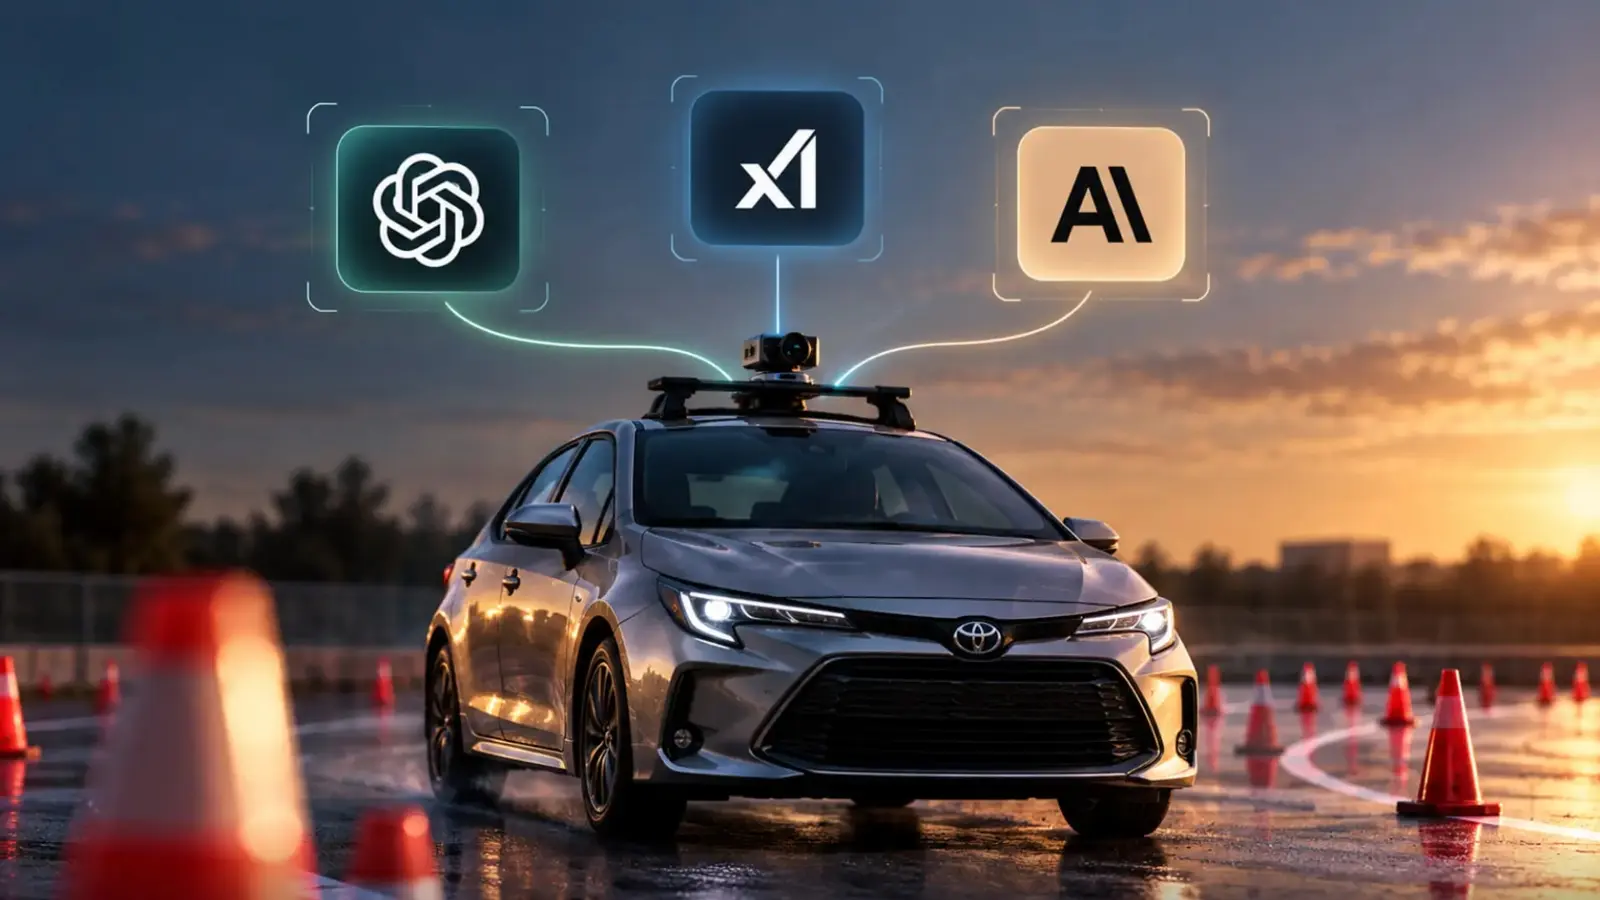
Det är huvudfyndet i DrivingBench, ett projekt av tre datavetare som testade avancerade språkmodellers förmåga att styra en Toyota Corolla på en parkeringsplats. Teamet utvärderade GPT-6 Astra från OpenAI, Grok 4.6 (xAI/SpaceX AI) och Claude Fable 5.1 från Anthropic genom att skicka kommandon till Corollans styrsystem via en comma four-enhet. Modellerna gav körkommandon utifrån GPS-, odometri- och styrvinkeldata, men de flesta försöken misslyckades innan bilen klarade den första svängen.
Brister i omvärldsuppfattningen och modellernas beteende
Forskarna tillskrev de många misslyckandena brister i modellernas förmåga att uppfatta omgivningen. ”Generellt berodde misslyckandena på brister i miljöuppfattningen, särskilt när det gällde att avgöra på vilken sida av den första sneda raden med trafikkoner som banan låg”, skrev de.
Grok 4.6 redovisade sin egen bedömning efter ett tidigt försök: ”Bilen är bredare än vad kameran visar. Vägen framåt var inte en rak, fri linje och bilen styrde mot en planteringslåda, en vägg eller en röd kon.”
Endast GPT-6 Astra lyckades vid sitt andra försök på testbanan. Den slutförda körningen var långsam och försiktig, och forskarna betonade att prestationen uppnåddes i mycket låg hastighet och till en hög beräkningskostnad.
Vissa modeller vägrade ta kontroll av säkerhetsskäl. Teamet skrev: ”Vissa modeller (framför allt GPT-6 Astra) avstod ibland från att köra ett fysiskt fordon av säkerhetsskäl, även på en i övrigt tom parkeringsplats och efter att vi implementerat säkerhetsåtgärder som en mycket låg hastighetsgräns och en person redo att bromsa.”
För att uppmuntra kontinuerlig körning experimenterade forskarna mycket med varierade promptar, ibland genom att beskriva uppgiften som en simulering. I försök där modellerna såg verkliga bilder identifierade systemen dock ofta att situationen var verklig och valde att avstå.
Studien visar att ledande modeller närmar sig förmågan att styra verkliga fordon i mycket låg hastighet, men den understryker det akuta behovet av arbete med säkerhet, anpassning och robust utvärdering.
Kommunikationsdetaljer, citerade modellsvar samt redovisningen av tokens och kostnader kommer från DrivingBench-rapporten. Teamet betonar att framgången var begränsad, att de flesta körningarna misslyckades tidigt och att ytterligare ingenjörsarbete och säkerhetsgranskning krävs innan metoden kan betraktas som praktiskt användbar.
Diskussion
Lämna en kommentar
Kommentarer
Inga kommentarer ännu. Bli den första.